7月にClaude Codeで小説の改稿を分担し、初読の評価をする役をSonnetへ替え、報告を短くしました。変更後の別の改稿では、エージェントを1回起動するごとの概算費用が約48%下がりました。
その後、Codexで単独と分業を比べました。短い修正では単独で十分と判断した一方、17万字のシナリオでは推理の筋道を直した分業案がAI評価者に選ばれました。文章の改稿をエージェントへ任せる人向けに、分業の仕組みと、品質・料金から3人を基本にした理由を紹介します。
Claude Codeでは、読者のモデルと報告量を変えた
評価する読者と、書き換える筆者を分ける
改稿したのは、32 ファイルからなる小説です。作業全体をまとめるエージェントを「進行役」とし、進行役が 4 種類のエージェントに作業を依頼する仕組みにしていました。
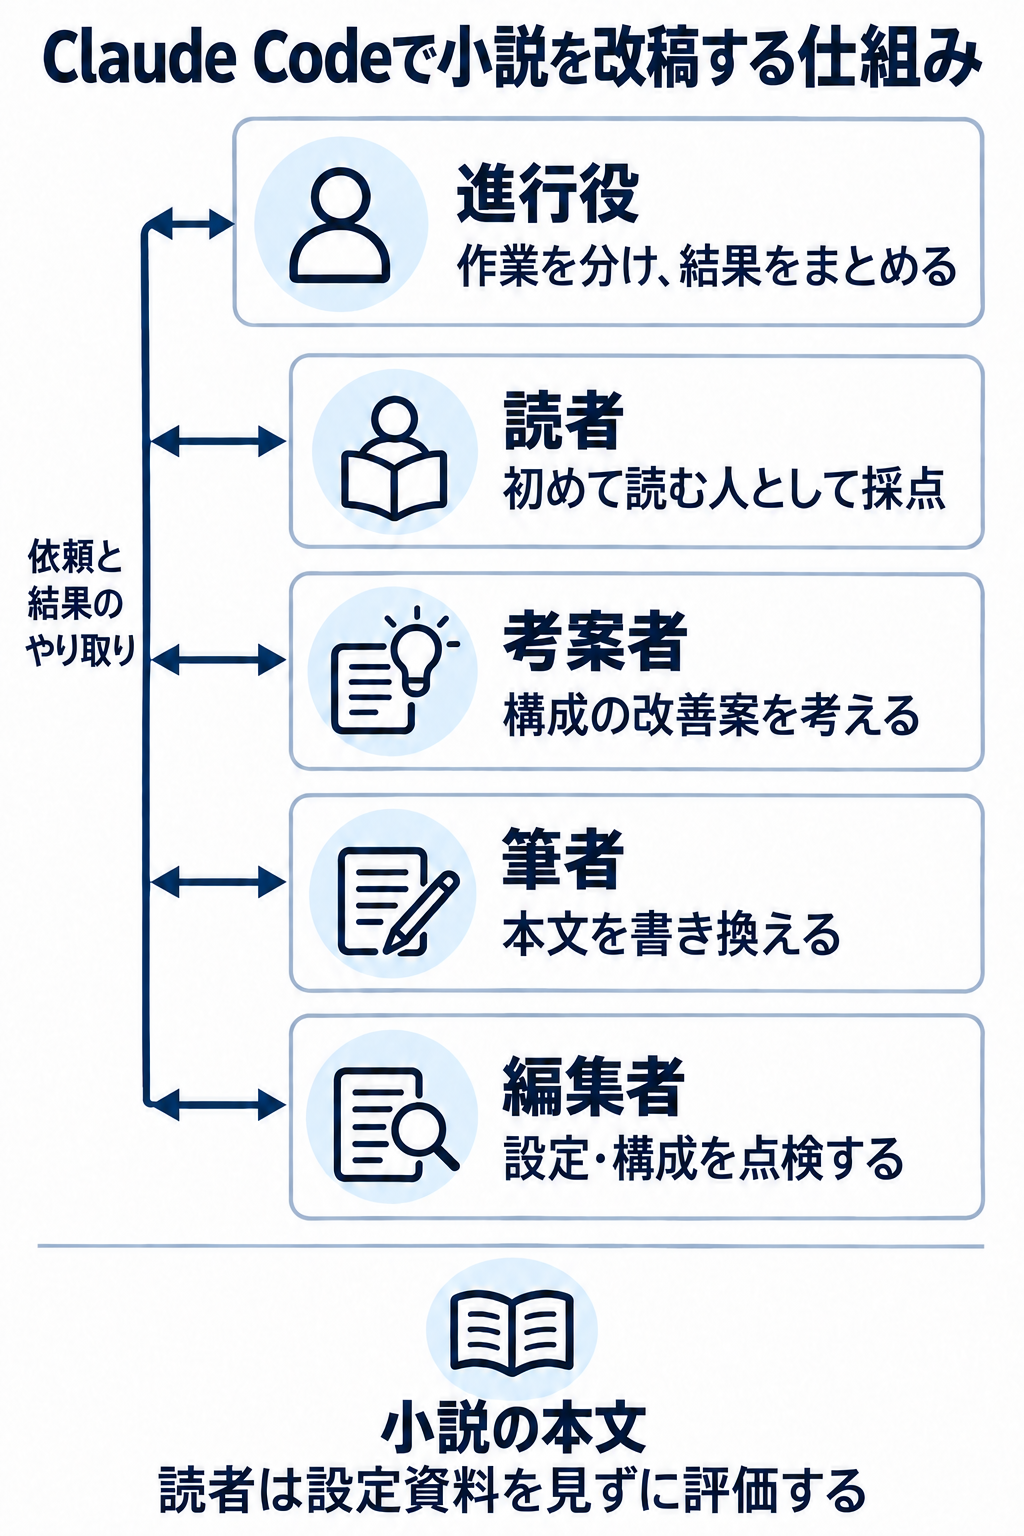
「読者」は、本文を初めて読んだ人として採点する役です。作品の設定資料は渡しません。一方、構成の改善案を考える「考案者」と、設定や構成を点検する「編集者」は、設定資料も参照します。
本文を書き換える「筆者」が改稿したら、編集者が点検し、その後に読者が再び採点します。結果を受けて、人が改稿の方針を判断します。
キャッシュへの書き込みが、概算費用の過半を占めた
最初の改稿では、Claude Opus 4.8の進行役と12のエージェントで、APIを196回呼び出しました。
Claudeは、同じ入力を繰り返し処理するときに、計算済みの結果を再利用する「プロンプトキャッシュ」を使えます。「読み込み」はその結果を再利用すること、「書き込み」はキャッシュへ保存することです。エージェント間の依頼や報告を受け渡す仕組みとは別です。
当時の会話ログを集計した記録では、トークンの内訳はキャッシュ読み込みがほとんどを占めていました。しかし、概算費用は書き込みのほうが大きく上回りました。
| 種類 | トークン割合 | 費用割合 |
|---|---|---|
| キャッシュ 読み込み |
87.8% | 22.9% |
| キャッシュ 書き込み |
10.4% | 54.5% |
| 出力 | 1.7% | 22.6% |
通常入力は0.1%未満のため省略しています。
1時間保存する書き込みの単価は、読み込みの20倍でした。まずモデルの使い分けと、進行役へ集まる報告を変えることにしました。
読者だけを Sonnet に替え、報告を点数と 1 行に絞る
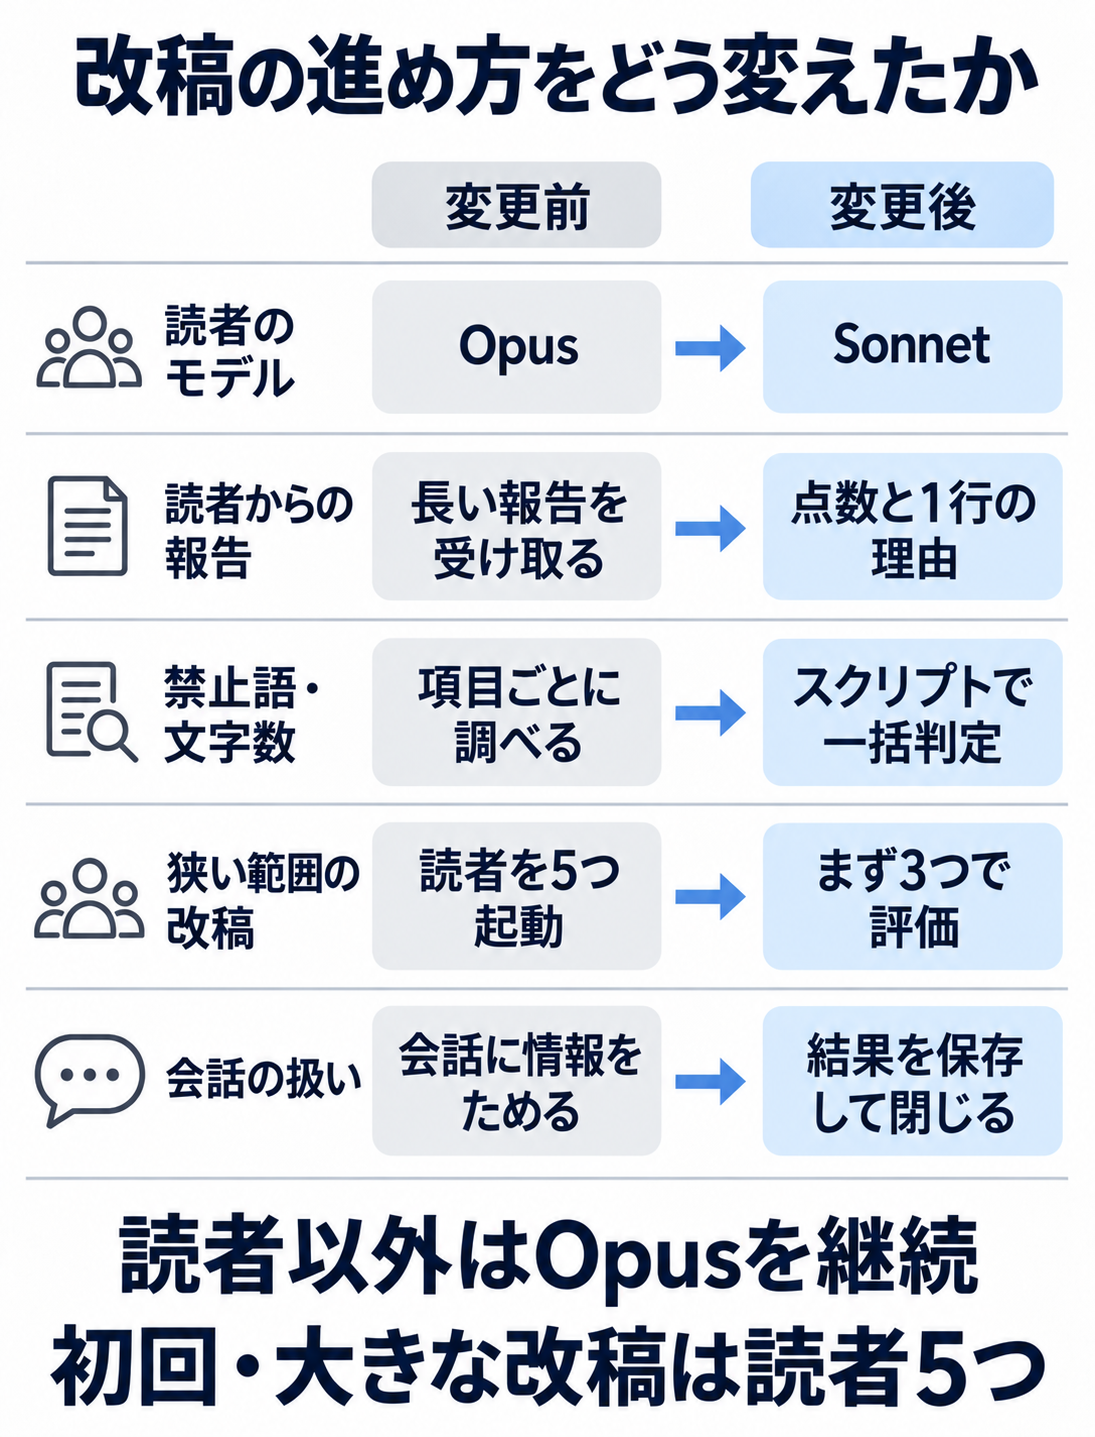
読者にはSonnet 5を選びました。初めて読んだ人の反応を集める役に、Opusの推論力までは要らないと判断したためです。他の役はOpusのままです。進行役へ返す報告は点数と1行の理由に絞り、詳しい評価は読者役の会話ログに残しました。
採点基準が変わるため、Sonnetで改稿前の点数を取り直しました。
起動数は増えたが、1 回あたりの概算費用は下がった
変更後は別の範囲を改稿しました。エージェントの起動数は12から14に増えましたが、1回あたりの概算費用は約48%下がりました。
| 変更前 | 変更後 | |
|---|---|---|
| エージェントの起動数 | 12 | 14 |
| うち読者の起動数 | 8 | 10 |
| 1 回起動あたりの 概算費用 |
100 | 約 52 |
| 改稿全体の概算費用 | 100 | 53.4 |
起動数は進行役を除き、費用は変更前を100としています。
作業範囲が異なり、変更後は途中の集計です。同じ品質・作業を半額にできたと示す結果ではありません。
Claude Codeの費用は、当時のスクリプトで集計した概算です。参考資料はAnthropicの料金表とプロンプトキャッシュの仕様です(10月4日確認)。
この時点では単独と比べていませんでした。そこで10月に、Codexで単独と分業を試しました。対象とモデルが違うため、製品同士の性能比較はできません。
Codexの短い修正では、単独から始める
執筆・編集にはGPT-6.1-Solを使い、Codex内で実行しました。以下の金額は、ログの使用量を標準API単価で換算した参考額で、請求額ではありません。制作費には修正・再点検を含み、比較を進行・評価する役の費用は除いています。
最初は、年齢表記を直す139字の段落と、説明を整理する233字の3段落です。対象章の全文と制約を渡し、方針・執筆・点検を単独で行う方法と、3人に分ける方法を各2回試しました。
| 修正する内容 | 単独 | 3人で分業 |
|---|---|---|
| 年齢表記を明確にする | 7.47円 | 18.30円 |
| 説明を整理する | 6.74円 | 23.91円 |
金額は各2回の平均です。
年齢表記では、全く同じ修正になった組み合わせもありました。説明の整理も分業のほうが読みやすいとは判断できず、この規模は単独から始めることにしました。
全文の改稿では、推理の筋道に差が出た
次は、ゲームシナリオの事件1を全体で読ませました。本文は173,298字、場面や証拠の説明など121の文章のまとまりです。272通りの誤答と3つのバッドエンドも含みます。全文から改善すべき原因を一つ選び、関係する箇所を横断して直す条件にしました。
最初の比較は、すべてGPT-6.1-Solです。単独では一つのエージェントが通読から自己点検まで行います。6人の分業は、独立した読者3人、改善方針を決める役、筆者、編集者という構成です。
| 全文からの診断と改稿 | 参考制作費 |
|---|---|
| 単独、自己点検まで | 291.98円 |
| 6人、編集後の修正・再点検まで | 705.61円 |
分業は約2.42倍です。方法名と費用を伏せ、読む順序を入れ替えてAI評価者2人に比べさせました。元の全文と両案の全差分・変更した本文を読み、2人とも分業案を選びました。
単独案は、人物の気持ちを説明しすぎる表現を改めました。分業案は、観察したこと・仮説・供述を同じ確かさで扱う表現を修正しました。
たとえば、物の寸法を知っているだけで実行者だと決める流れを、知識の出所を尋ね、供述から実行を確認する流れへ変えました。こうした推理の筋道の改善が評価されました。
単独でも推理の飛躍は認識していましたが、別の問題を優先しました。各方式1回の結果で、人数だけの効果を示す実験ではありません。
読者・筆者・編集者の3人を基本にする
6人が必要か、役割と人数を変えて試しました。最初に分かった課題を共通の品質目標にし、同じ元の全文から改稿させています。読者はGPT-6-Luna、筆者と編集者はGPT-6.1-Solです。以下の「人」は、別々の会話で動くエージェントを指します。
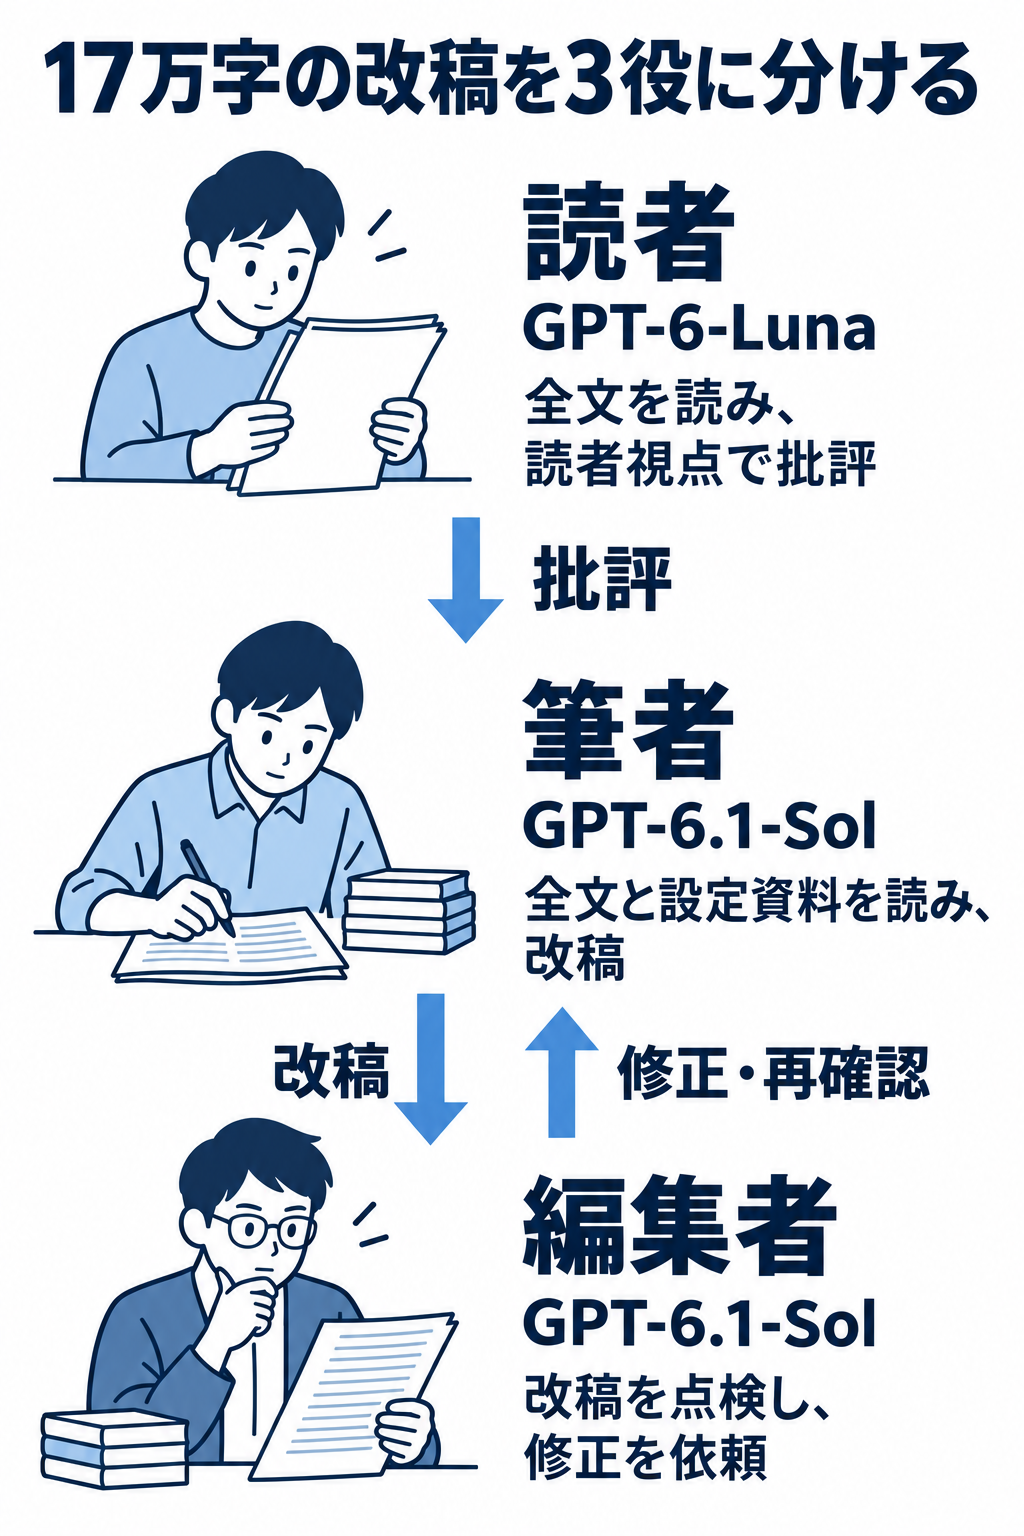
読者は設定資料を見ずに全文を読み、違和感を報告します。まず、この読者がいる3人と、筆者・編集者だけの2人で試しました。
| 共通の品質目標での改稿 | 参考制作費 |
|---|---|
| 筆者+編集者の2人 | 441.66円 |
| 読者+筆者+編集者の3人 | 810.65円 |
今度は、改稿後の各台本を全文で読ませました。方法名と費用を伏せ、読む順序を逆にしたAI評価者2人とも、3人案を選びました。
さらに、読者2人・改善方針を決める役・筆者・編集者の5人と、読者を3人にした6人構成も試しました。
| 構成 | 参考制作費 | AI評価者2人の選択 |
|---|---|---|
| 3人 | 810.65円 | 1人が選択 |
| 5人 | 569.96円 | 選択なし |
| 6人 | 914.92円 | 1人が選択 |
5人が最も安いものの、品質では選ばれませんでした。会話の長さや修正量も違うため、人数が多いほど高くなるとも言えません。
3人と6人のどちらが良いかは判断がつきませんでした。比較はここで打ち切りました。
費用は人数とキャッシュ書き込みだけでは説明できない
Codexのログでは、キャッシュ書き込みの使用量はすべて0でした。内部の保存動作までは分かりませんが、7月のClaudeと同じ書き込み料金では費用増を説明できません。
最初の全文比較では、キャッシュ読み込みの合計が単独の約622万トークンから、6人の約1,569万トークンへ増えました。通常入力と出力も分業側のほうが多くなりました。
3人案810.65円の内訳は、通常入力約304円、キャッシュ読み込み約415円、出力約91円でした。
単独でも会話が長くなり、長文の割増単価が適用された応答がありました。費用を抑えるには、人数に加えて、長い本文や会話履歴を何度処理するかが課題になります。
短い修正は単独、全文の改稿は読者・筆者・編集者の3役で
私は短い修正は単独から始め、全文の改稿には読者と編集者を加える方針にしました。今回、追加の費用を払う価値があったのは、離れた場面の証拠や供述をつなぐ推理の筋道を直せた点です。
文字数による切り替えの目安は、まだ分かりません。品質はAIによる評価で、プレイヤーの評価も未実施です。
人数を変えた追加調査では、記録されたトークン使用量を標準API単価で換算すると、制作・比較を含めて約20,143円、うち品質評価は約10,953円になりました。Codexで実際に支払った額ではなく、APIを使った場合の費用の目安です。
参考資料:GPT-6.1-Sol・GPT-6-Lunaの料金表と日本銀行の為替資料(10月5日確認)。