スクリーンショットから AI に表示崩れを探させるとき、強いモデルは安いモデルの 20 倍の料金がかかります。安いモデルでどこまで分かるのか、崩れを 5 件仕込んだページで試しました。
安いモデル(gpt-6-luna)は間違った指摘をしませんでしたが、重なりとラベル切れを 2 回とも指摘できませんでした。直しながらの確認は安いモデルで回して、最後に一度だけ強いモデル(gpt-6-sol)にも頼むのが良いと考えています。
試したこと
タスクを 3 列に並べたダッシュボード風のページに、崩れを 5 件入れました。
| 仕込んだ崩れ | |
|---|---|
| D1 | 長い URL のタイトルがカードの外まで伸びる |
| D2 | 「承認待ち」のバッジがタイトルの上にかぶる |
| D3 | ほとんど読めない薄い文字(コントラスト比 1.18) |
| D4 | スマホ幅(390px)でページ幅が 740px になり、横スクロールが出る |
| D5 | 幅を固定したボタンで、ラベルが途中で切れる |
「…」で省略した説明文、タスクのない列、押せないボタンのような、崩れではない見た目も入れてあります。これを崩れと言ったら誤検知です。
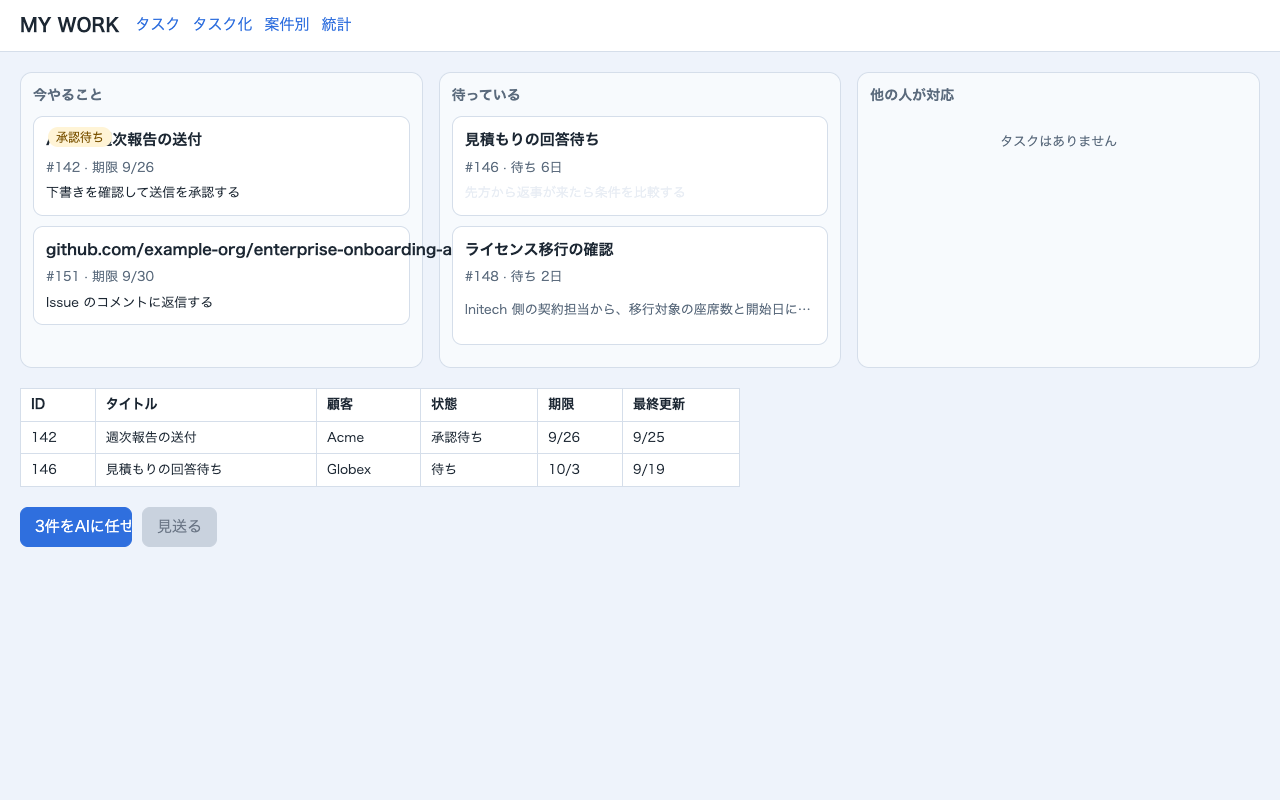
幅 1280px と 390px のスクリーンショット 2 枚と、見てほしい観点(はみ出し、重なり、読めない文字、切れたラベル、スマホ幅での横スクロール)を、Codex CLI 0.157.0(ChatGPT アカウント)に渡しました。HTML は入力に含めていません。モデルと effort(考える量の設定)を変えて、1 回ずつ新しいセッションで 2 回ずつ試しています(2026-09-25)。
gpt-6-sol の API 料金は、入力も出力も gpt-6-luna の 20 倍です(料金表、2026-09-26 取得)。参考に、Claude Code のサブエージェント(Claude Opus 5.5)にも同じ指示と画像を渡しました。
安いモデルは重なりとラベル切れを指摘できない
| モデル / effort | 指摘した崩れ(2 回) | 1 回の料金 | 時間 |
|---|---|---|---|
| gpt-6-luna / low | 3 件、3 件 | 約 0.2 円 | 16〜28 秒 |
| gpt-6-luna / xhigh | 4 件、3 件 | 約 0.4 円 | 89〜95 秒 |
| gpt-6-luna / max | 3 件、4 件 | 約 0.4 円 | 87〜103 秒 |
| gpt-6-sol / low | 4 件、4 件 | 約 2.5〜6.0 円 | 16〜17 秒 |
| gpt-6-sol / medium | 5 件、5 件 | 約 4.8〜4.9 円 | 23〜28 秒 |
| gpt-6-sol / high | 5 件、5 件 | 約 5.2〜5.4 円 | 26〜32 秒 |
| 参考: Claude Opus 5.5 | 5 件、5 件 | 約 40 円 | 39〜56 秒 |
料金は、codex exec --json の最後の行の usage にあるトークン数に API の単価を掛け、1 ドル 157.25 円(Trading Economics、2026-09-26 取得)で円にしました。ChatGPT アカウントの Codex は週の使用枠から出るので、実際にこの額を払ってはいません。
Claude Opus 5.5 は測ったときのトークン数が残っていなかったので、2026-09-26 に同じ指示と元の画像で 2 回やり直して測りました(2 回とも 5 件、22〜23 秒)。サブエージェントのログにあるトークン数に、Anthropic の料金表(2026-09-26 取得)の単価を掛けています。1 回 40.4 円と 41.6 円で、gpt-6-sol / high の 8 倍ほどです。入力の大半は Claude Code の指示とツール定義と画像の約 4.6 万トークンで、これが毎回キャッシュへの書き込み(100 万トークンあたり 5 ドル)として課金されていました。こちらも Claude の定額プランの中で動かしたので、この額は払っていません。
誤検知はどの条件でも 0 件でした。スマホ幅で文字が右端で切れているという指摘は、D4 のはみ出しが原因なので D4 として数えています。
違いは指摘できなかった箇所です。gpt-6-luna / low の回答には、2 回とも D2(バッジとタイトルがかぶる)と D5(ラベル切れ)がありませんでした。gpt-6-sol / low では D2 が残り、medium 以上は 2 回とも 5 件すべてを指摘しました。
gpt-6-sol / low の料金に幅があるのは、キャッシュから読めた入力の量が回ごとに違ったからです。前の実行と同じ入力はキャッシュから読まれ、単価が 10 分の 1 になります。
記事の画像は、ページにあった実在の社名を架空の名前に差し替えて、2026-09-26 に撮り直したものです。表は差し替える前の画像で測りました。撮り直した画像で gpt-6-luna / low をもう 2 回試すと、結果は 3 件と 2 件でした。D2 と D5 はここでも指摘せず、2 回目の回答には D3 の薄い文字もありません。
effort を上げても 5 件全部は拾えない
gpt-6-luna の effort を xhigh や max に上げると、D2 か D5 の片方を指摘した回はありました。両方を指摘した回はありません。
出力は約 5 倍、時間は約 4 倍(1 分半ほど)、料金は約 1.7 倍になりました。入力は effort によらず約 3.7 万トークンで、増えたのは出力だけです。AI が考えた分のトークンは、画面に出なくても出力として課金されます(Reasoning models、2026-09-26 取得)。
一方で gpt-6-sol / low は、20 秒かからずに 2 回とも 4 件を挙げています。
安いモデルで回して、最後に強いモデルに頼む
安いモデルの指摘は全部本物だったので、そのまま直してよさそうです。1 回 0.2 円ほどで、20 秒前後で返ってきます。
最後に強いモデルで調べ、指摘された崩れを直したら、同じモデルでもう一度確認します。gpt-6-luna / low は D2 と D5 を 4 回とも指摘できなかったため、修正後の判定には使えません。
ちなみに、今回の 5 件はブラウザ上の座標計算でも全部取れました。崩れが本当にあることも、これで確認しています。よくある崩れは AI に頼む前にスクリプトで拾う手もありそうですが、まだ試していません。
モデルと effort を変えて同じ画像を調べる
計測時は、2 枚の画像を開いて JSON 配列で答える指示を codex-prompt.txt に保存し、次のように実行しました。-m と model_reasoning_effort を変え、毎回新しいセッションで試しています。
$ codex exec --skip-git-repo-check -s read-only -m gpt-6-luna -c model_reasoning_effort=low "$(cat codex-prompt.txt)" < /dev/null
[{"screenshot":"desktop","where":"「やること」の2件目のカード","problem":"長いタイトルが改行・省略されず、隣の「待っている」カードに重なっている。"},{"screenshot":"mobile","where":"画面全体","problem":"画面幅を超えて右側が切れている。ナビゲーション、カード内の長いタイトルや本文、「他の人が対応」欄が途中で見切れており、横スクロールが必要になるレイアウトに見える。"}]
これは撮り直した画像で試した 2 回のうち 2 回目の出力です(2026-09-26、Codex CLI 0.157.1)。D1 と D4 を指摘しました。表の料金には、差し替え前の画像で --json を付けて実行したときのトークン数を使っています。
まとめ
安いモデルは間違った指摘をしませんでした。ただ、同じ画像で何度試しても effort を上げても、特定の崩れは残りました。
指摘が正しければ、修正のたびに安いモデルを使えます。最後に強いモデルで、残った崩れを探します。ページ 1 つ、崩れ 5 件、各 2 回なので傾向止まりで、指摘できない箇所がモデルで決まるのかページで決まるのかも分けられていません。
AI に確認を任せるなら、どのモデルが一番いいかを探す前に、答えの分かっている題材で、使うモデルが指摘できない崩れを先に知っておくと、安いモデルに任せる範囲を決めやすくなります。